RAGとは?生成AIでの社内データ活用による作り方と事例をわかりやすく解説
この記事の結論
社内データを活用したRAGは、「RAGとは何か」という基礎を押さえたうえで、データソースの棚卸しからアーキテクチャ選定、検索精度向上、運用評価までを一連の流れで設計することで、業務で使える水準に近づけられます。
スモールスタートで試験運用を重ね、社内文書の形式や利用部門に合うパターンを選ぶことが、安定運用への近道になります。
本記事は、RAGの定義から作り方、精度向上の観点、そして実際の活用事例までを1本にまとめた「RAGの決定版ガイド」です。「RAGとは何か」を知りたい方も、「自社でどう構築すればよいか」を知りたい方も、この記事だけで全体像を把握できます。
- RAGとは何か(AIとの関係、生成AIとの違い)
- 社内データを活かすRAGの作り方の全体手順
- 社内利用に向くアーキテクチャパターンの違いと選び方の観点
- 回答精度を高めるためのチャンク設計・検索方式・評価運用の要点
- 業種・部門別のRAG活用事例
社内のExcel、Word、PDFといった多様なデータを生成AIとどうつなぎ、運用しやすい仕組みに落とし込むかは、多くのDX推進担当者が直面する課題です。
「RAGとは」「RAG AI」といったキーワードで情報を探す場合でも社内システムへの活用を検討する際は、データ整備や検索基盤、権限設計まで含めて論点を整理する必要があります。
本記事では、社内システムでの利用を想定したRAGについて、基本の定義から、構築時の手順・アーキテクチャパターン・精度改善の観点、活用事例を整理します。
目次
- RAGとは?社内データを活用した生成AIで注目される理由
- そもそもRAGとは何か(AIとの関係)
- RAGの基本的な仕組み
- 社内データ活用でRAGが選ばれる背景
- 実際に最近増えている企業の生成AI・RAG開発相談
- RAGの作り方とは?社内データ活用の流れ
- 社内データの棚卸しと利用範囲の決定
- ベクトル化と検索基盤の構築
- スモールスタートでの試験運用と評価
- 社内RAGの導入・構築でお悩みですか?
- RAGのアーキテクチャ構成とは?作り方の違いについて
- 単一インデックス構成の作り方と適用範囲
- 複数データソース横断検索構成の作り方
- 業務システム連携型RAGの設計ポイント
- RAGの精度向上で重要なチャンク設計と検索方式
- RAGの活用事例
- 社内問い合わせ対応(総務・人事・情報システム部門)
- コールセンター・カスタマーサポートでの活用
- 営業・提案業務での活用
- 技術文書・仕様書の検索での活用
- よくある質問
- 社内のExcelやWordはRAGにそのまま使えますか?
- RAGはどのくらいで試験運用できますか?
- 社内RAGの回答精度はどう確認すればよいですか?
- RAGとRAG AI(AI RAG)は同じ意味ですか?
- RAG構築を成功させるための運用ポイントまとめ
RAGとは、社内知識をAIの回答生成に活かす仕組みのことです。
まずは基本を押さえて、自社のデータをどのように組み込むかを検討する必要があります。
そもそもRAGとは何か(AIとの関係)
「RAGとは」で検索する方の多くは、「生成AIとRAGは何が違うのか」「RAG AIとはどういう意味か」という疑問を持っています。結論からいうと、RAGはChatGPTやClaudeのような生成AI(大規模言語モデル)そのものではなく、生成AIに外部の知識を検索させて回答させるための仕組みです。
生成AI単体では、学習データに含まれていない自社固有の情報(社内規定、製品仕様、過去の対応履歴など)に基づいた回答はできません。RAGを組み合わせることで、生成AIが社内データを「調べながら答える」ことができるようになり、これが「AI RAG」「RAG AI」という表現で呼ばれる仕組みの正体です。つまりRAGは、生成AIの回答精度と信頼性を高めるための拡張技術と理解すると分かりやすいでしょう。
RAGの基本的な仕組み
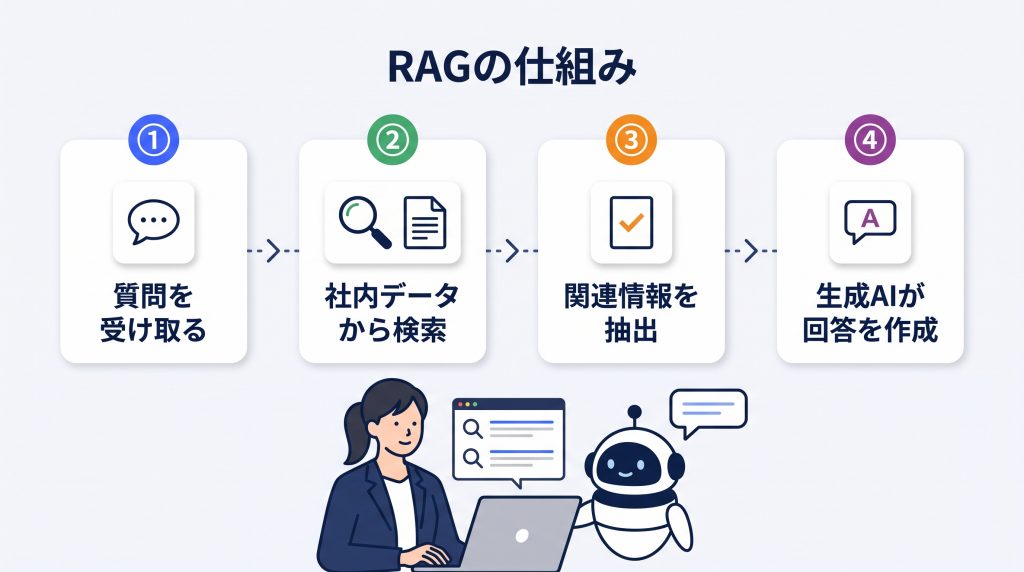
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と訳されます。
質問文と意味的に近い情報を外部の知識ソースから検索し、その内容を大規模言語モデルへ渡して回答を生成する仕組みです。
キーワードが完全に一致しなくても関連する文書を参照できるため、社内文書を知識ソースとすれば業務知識を回答に組み込めます。
社内データ活用でRAGが選ばれる背景
社内システムとして、社内の既存データを活用する際にRAGが選ばれる理由には、社内知識を回答生成に活かし、根拠も示せる基盤であるという背景があります。
生成AIを業務に活用する際、一般的な知識だけでは対応しきれない社内固有の情報が必要なケースは多くあります。
RAGは社内文書やナレッジベースを参照して回答を生成できるため、自社の業務ルール、過去事例、製品情報などを反映した回答を得やすい点が特徴です。
また、情報を外部に出さずに社内で管理・活用したい企業にとっても、現実的な手段として選ばれています。
生成AIの情報漏洩が起きる仕組みと防止策について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:生成AIの情報漏洩が起きる仕組みと事例|業務で安全に運用するための防止策
実際に最近増えている企業の生成AI・RAG開発相談
CLINKSへのご相談で、実際に最近もっとも多いご相談は、自社のナレッジを学習させた専用のRAGシステムの構築です。
クラウドサーバーに上がっているデータを丸ごと参照し、質問に対して全データの中から適切な情報を用いて回答するシステムの開発が弊社へのお問い合わせが増加しています。
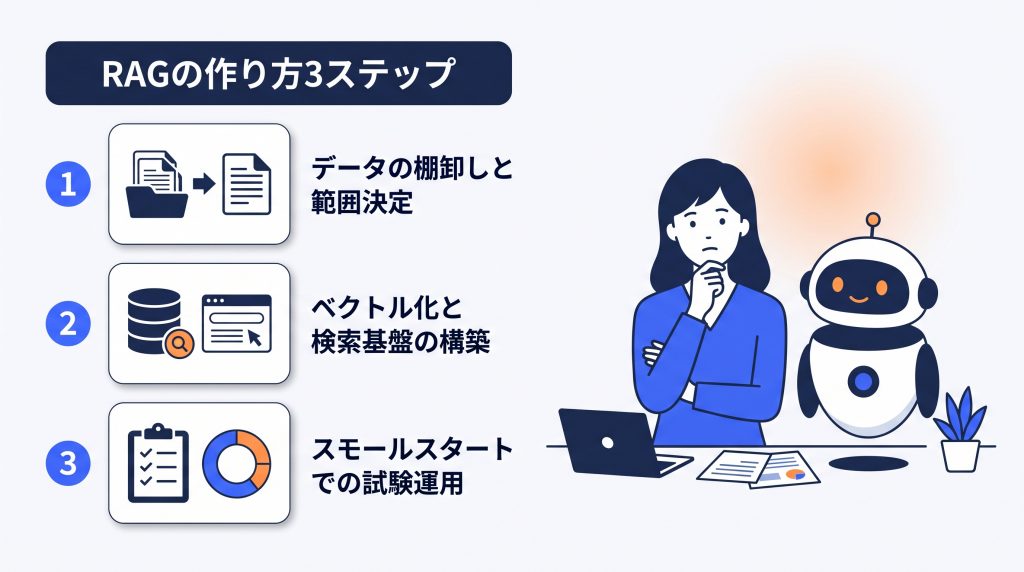
社内データでRAGを構築するには、データの棚卸しから検索基盤の構築、試験運用までを段階的に進めることが重要です。
社内データの棚卸しと利用範囲の決定
社内データを活かすRAGは、対象範囲を絞ることから設計を始めます。
Excel、Word、PDFなどのファイルが分散している実態を整理し、最初に扱う部門や業務シーンを絞ることで構築を現実的に進められます。
アクセス権限の境界もこの段階で確認しておくと、後の設計を進めやすくなるでしょう。
対象範囲の選定が、構築全体の複雑さを左右します。
ベクトル化と検索基盤の構築
RAGの中核は、文書を検索できる形に変換し、その検索基盤を用意する点にあります。
大きな文書は分割(チャンキング)して埋め込みモデルでベクトル化し、ベクトルデータベースに格納する流れです。
質問が入力されると、類似検索でチャンクが取り出され、大規模言語モデルへ渡されて回答が生成されます。
この検索と生成をつなぐベクトル化が、RAGの骨格となります。
スモールスタートでの試験運用と評価
小さく始めて検証を重ねることで、現場に合わせた調整ができます。
一部部門・特定業務に絞って試験し、回答品質と運用負荷を確認します。
質問と回答を記録して調整を重ね、効果を確認しながら展開範囲を広げることが安定した運用への近道です。
社内データを活かすRAGは、棚卸し・基盤構築・試験運用を順に進めることで、実運用を乗せやすくなります。
AI導入をスモールスタートで進める考え方については、こちらの記事で詳しく解説しています。
併せてご覧ください。
関連記事:社内向けAI導入をスモールスタートで進める費用と段階的投資の設計手順
社内RAGの導入・構築でお悩みですか?
RAGの構築手順を把握しても、以下のような不安が残る方は多いのではないでしょうか。
- 「自社のデータ形式や既存システムとの接続をどう設計すればよいかわからない…」
- 「実際に動かせる水準に持ち込めるか不安…」
CLINKSでは、データ棚卸しの整理からベクトル検索基盤の設計・構築、試験運用の設計まで、社内RAG導入を一貫して支援しています。まずはご相談ください。
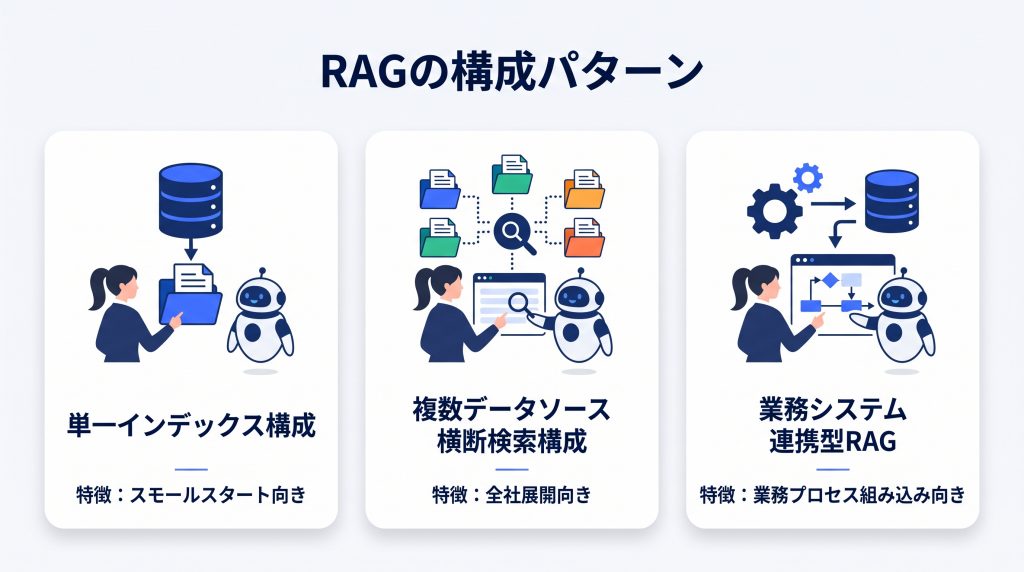
RAGの作り方は、扱うデータソース・検索範囲・アクセス権限・既存システムとの連携方法によって変わります。
利用シーンに合った構成を選ぶことが、安定した運用の土台になります。
アーキテクチャは要件によりさまざまですが、ここでは一般的なパターンを3つ紹介します。
単一インデックス構成の作り方と適用範囲
単一インデックス構成は、特定部門のFAQやマニュアルなど、対象範囲を限定した知識ソースを一つの検索インデックスに集約するシンプルな構成です。
構築コストを抑えやすく、対象データが限定されている場合は検索精度や運用管理を維持しやすくなります。
一方で、複数部門・複数権限の文書を扱う場合は、メタデータ設計やアクセス制御が複雑になりやすいため、まずはスモールスタートで試したい企業に適した作り方です。
複数データソース横断検索構成の作り方
複数データソース横断検索構成は、総務・人事・営業など、複数部門の知識ソースを横断して検索できる構成です。
文書の種類や管理部門が混在するため、誰がどの情報を参照できるかを制御するアクセス権限設計が重要になります。
また、知識ソースの更新、メタデータ付与、検索品質の評価を継続できる運用体制も必要です。全社展開を見据える企業に向いた作り方といえます。
業務システム連携型RAGの設計ポイント
業務システム連携型RAGは、ERP、CRM、基幹システム、社内データベースなどの業務データを参照し、業務フロー内で回答や判断支援に活用する構成です。
API連携・データ抽出・同期方式・権限管理・データ形式の変換が、設計上の重要ポイントになります。
文書検索だけでなく、業務プロセスへの組み込みを目指す企業に適した構成です。
RAGのアーキテクチャは、目的・データの範囲・アクセス権限・社内の運用体制に合わせて選ぶことが重要です。
構成ごとの違いを把握することで、運用しやすいRAGの作り方を判断しやすくなります。
業務システムを操作して仕事を進めるAIエージェントの仕組みと使い方について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:AIエージェントとは?仕組み・種類・業務での使い方を実例でわかりやすく解説
RAGの回答精度は、文書側のチャンク設計と検索方式を整えることで業務で使える水準に近づけられます。
生成AIのハルシネーション対策と業務リスクの統制について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:生成AIのハルシネーション対策と業務リスク統制の実践ガイド
チャンク分割とメタデータ設計
意味のまとまりを意識したチャンク設計が、RAGの精度向上に大きく影響します。
WordやPDFは見出しや段落の区切りを意識して分割し、文書種類・部門・更新日などのメタデータを付与することで、不要な文書が回答に混入するリスクを抑えられます。
文書側の設計を整えることが精度を高める最初の一歩です。
| 設計項目 | 内容 | 精度への影響 |
|---|---|---|
| チャンク分割 | WordやPDFを意味のまとまりごとに分割する | 必要な情報を適切に抽出しやすくなる |
| 見出し・段落単位の整理 | 文書の構造を意識して区切る | 関連性の低い文章混入を防ぎやすい |
| メタデータ付与 | 文書種類・部門・更新日などの情報を付ける | 検索対象を絞り込み回答精度が向上する |
ベクトル検索だけでなく、従来のキーワード検索も組み合わせるハイブリッド検索が、回答精度の改善や速度向上に有効です。
ベクトル検索は意味的な類似性で探しますが、固有名詞や型番が含まれる場合はキーワード検索を組み合わせることで精度・速度を補えるのが特徴です。
リランキングで上位を絞り込むとモデルに渡す情報の質が高まり、検索方式の組み合わせ方がRAGの回答精度を左右します。
| 検索方式 | 特徴 | 役割 |
|---|---|---|
| ベクトル検索 | 意味的な類似性をもとに検索する | 文脈に近い情報を取得する |
| キーワード検索 | 特定の単語をもとに検索する | 固有名詞や型番を正確に検索する |
| ハイブリッド検索 | 2つの検索方式を組み合わせる | 検索精度と速度を補完する |
| リランキング | 検索結果を関連度で再評価する | モデルに渡す情報の質を高める |
チャンク設計と検索方式の両面を整えることで、RAGの精度は業務で使える水準に近づきます。
RAGを構築しても、従業員が実際に活用し、業務にポジティブな影響を与えなければ意味がありません。
業務に定着させるための考え方については、こちらの記事で解説しています。
併せてご覧ください。
関連記事:生成AIの導入を成功へ導く業務選定と実行設計の進め方
チャンク設計やハイブリッド検索の組み合わせ、評価サイクルの運用設計は、技術的な判断が重なる工程です。
CLINKSは、GPTやClaudeなど複数のAIモデルの特性を踏まえ、RAGの精度向上に必要なベクトルDB設計から検索方式の選定・評価運用の仕組みづくりまでを一貫して支援します。
CLINKSのサービスや開発実績などは、以下のページでご覧いただけます。
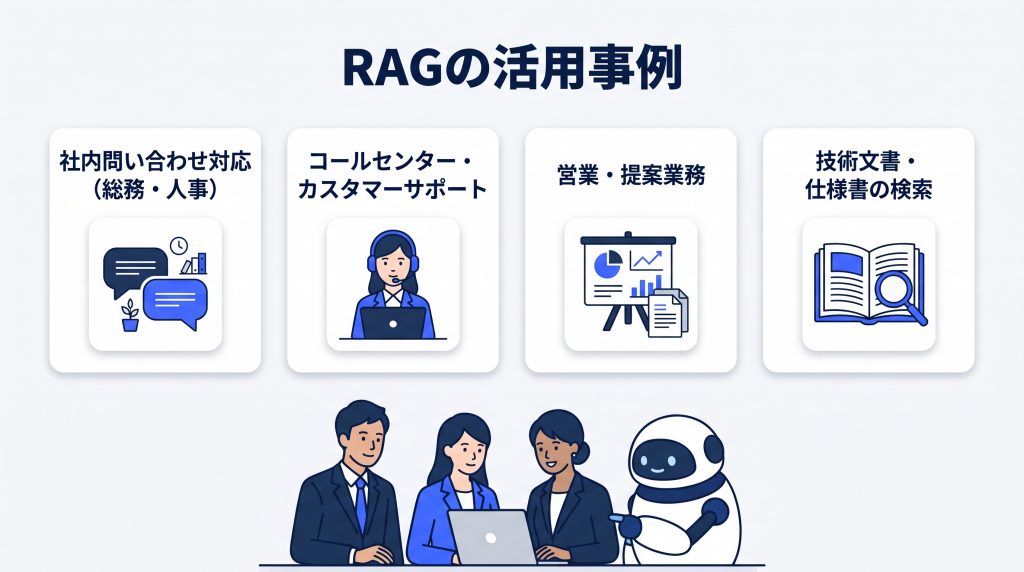
RAGは業種や部門を問わず、「社内に蓄積された情報を、必要な人がすぐに引き出せる」という課題解決のために導入が進んでいます。代表的な活用パターンを紹介します。
社内問い合わせ対応(総務・人事・情報システム部門)
規程集やマニュアル、過去のFAQを知識ソースにRAGを構築し、従業員からの定型的な問い合わせにAIが一次回答する形で活用されています。担当部門への問い合わせ件数を減らし、担当者を判断業務に集中させる効果が期待できます。
コールセンター・カスタマーサポートでの活用
製品マニュアルや過去の対応履歴をRAGに接続し、オペレーターが応対中にリアルタイムで根拠付きの回答候補を参照できるようにする活用例です。新人オペレーターの立ち上がりを早める目的で導入されるケースもあります。
営業・提案業務での活用
過去の提案書、製品資料、事例集をRAGでつなぎ、営業担当者が提案作成時に類似事例や過去の成功パターンを検索できるようにする活用です。属人化していたナレッジを組織全体で使える状態にする狙いがあります。
営業部門でのAI活用事例と導入の進め方について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:AI活用事例5選!営業部門の売上向上と業務効率化を実現する考え方とは?
技術文書・仕様書の検索での活用
エンジニアリング部門やカスタマーエンジニアリング部門では、大量の技術文書・仕様書・設計資料をRAGの知識ソースとし、必要な仕様を素早く検索・確認する用途で活用されています。
技術文書のナレッジ化などから着手する製造業DXの進め方について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:製造業DXの進め方|検査・需給予測・技術文書から着手する
いずれの事例も、共通しているのは「対象範囲を絞ったスモールスタート」から始め、運用しながら参照範囲や精度を調整している点です。自社でどのパターンが適しているかは、業務内容やデータの整備状況によって異なるため、個別のご相談を推奨します。
以下では、生成AIのRAG設計に関して、よくある質問に回答します。
社内のExcelやWordはRAGにそのまま使えますか?
RAGはどのくらいで試験運用できますか?
社内RAGの回答精度はどう確認すればよいですか?
RAGとRAG AI(AI RAG)は同じ意味ですか?
社内データを活かすRAGは、まず「RAGとは何か」を正しく理解したうえで、データ棚卸し・ベクトル検索基盤の構築・試験運用という順で段階的に進めるのが基本です。
利用シーンに合わせてアーキテクチャパターンを選び、チャンク設計と検索方式を調整することで回答精度を高められます。
構築後も評価と改善のサイクルを継続することが、業務で使い続けられる運用の条件です。
対象業務とデータ範囲の整理から始めることで、スモールスタートでの導入が現実的になります。
CLINKSでは、RAG構築・自社専用生成AIチャットシステムなど、課題の特定からPoC、本格導入・運用フェーズまでを一体的に支援しています。
社内データを活かした生成AIの仕組み構築をどこから始めればよいかわからない場合でもご相談から承ります。
CLINKSの会社紹介、開発実績、ご成約からプロジェクト進行の流れについては、[以下のサービスページ]でご確認いただけます。