ファインチューニングとは?RAGとの違いと使い分けを、AI開発の現場視点で解説
「自社専用のAIを作るには、ファインチューニングが必要?」
「RAGとファインチューニングのどちらを選べばよいか分からない」
AIの導入・開発を検討するなかで、このようにお悩みではありませんか。
ファインチューニングは、既存のAIモデルに追加学習を行い、特定の業務に合うよう調整する手法です。
ただし、自社専用のAIを作るために必須というわけではありません。
社内規程やマニュアルを参照して回答させたい場合は、まずRAGを検討するのが一般的です。
一方、回答の形式や口調を揃えたい場合には、ファインチューニングが選択肢になります。
本記事では、Webシステム開発・運用契約企業600社以上の実績を持つCLINKSが、ファインチューニングの仕組みやRAGとの違い、目的に応じた使い分けを解説します。
生成AIを日常業務で活用する現場の視点から、自社に合う手法を選ぶための判断基準をお伝えします。
目次
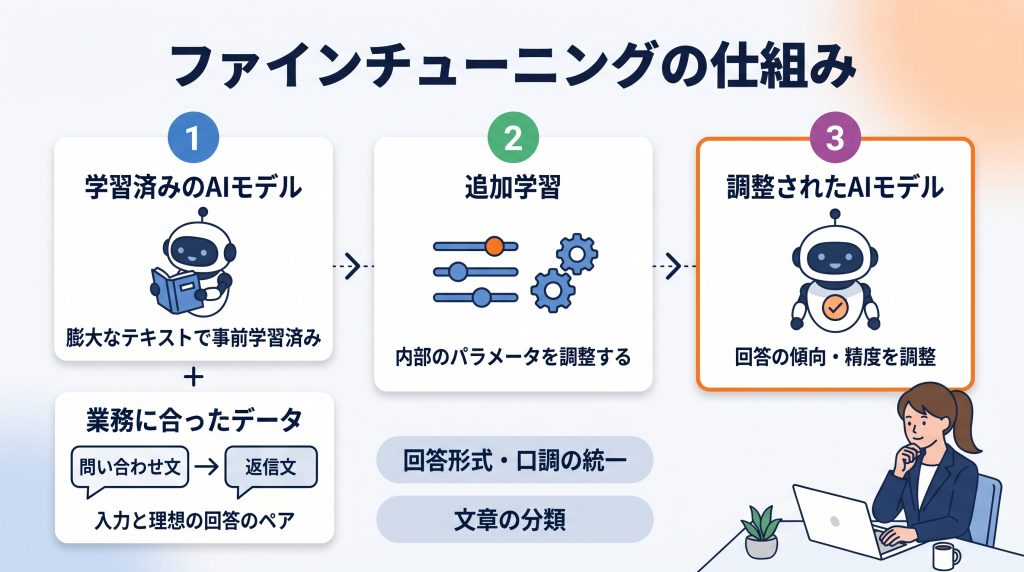
ファインチューニングとは、学習済みのAIモデルに業務に合ったデータを追加学習させ、回答の傾向やタスクの精度を調整する手法です。
回答形式や口調の統一、文章の分類などに活用されます。
大規模言語モデル(LLM)は、膨大なテキストによる「事前学習」を通じて、一般的な知識や言語のパターンを学びます。
ファインチューニングでは、そのモデルに入力と理想の回答などを学習させ、内部のパラメータを調整します。
例えば、問い合わせ文と適切な返信文のペアを学習させることで、自社の対応方針に沿った回答を生成しやすくできます。
主な学習方式は、次のとおりです。
| 方式 | 学習に使うもの | 向いている用途 |
|---|---|---|
| SFT(教師ありファインチューニング) | 入力と理想の出力のペア | 回答形式・口調の統一、文章の分類 |
| DPO(直接選好最適化) | 同じ入力に対する、好ましい回答と好ましくない回答のペア | 回答の好ましさや表現の調整 |
| RFT(強化学習型ファインチューニング) | 出力の正しさなどを採点する評価基準 | 専門領域での推論精度の向上 |
また、学習に必要な計算量やメモリを抑える手法として、LoRAがあります。
元のモデルの重みを固定し、一部の層に加えた小さなパラメータだけを学習させる仕組みです。
AI開発に必要なPCスペック(GPU・VRAM容量など)について詳しく知りたい方は、以下の記事をご覧ください。
ファインチューニングは、AIの回答の仕方を調整する場合に有効です。
一方、頻繁に更新される社内規程や最新情報を参照させたい場合は、必要な情報を検索して回答に利用するRAGが適しています。
ファインチューニングで得意なこと・苦手なこと
ファインチューニングの得意・不得意を整理すると、以下のとおりです。
| 得意なこと | 苦手なこと |
|---|---|
| 回答フォーマット・文体の統一 | 頻繁に更新される情報の反映 |
| 社内独自の分類ルールの再現 | 回答の根拠(出典)の提示 |
| 長いプロンプトを省き、推論コストを削減 | 新しい事実知識の正確な記憶 |
特に「新しい知識の記憶が苦手」な点が、RAGとの使い分けの鍵になります。
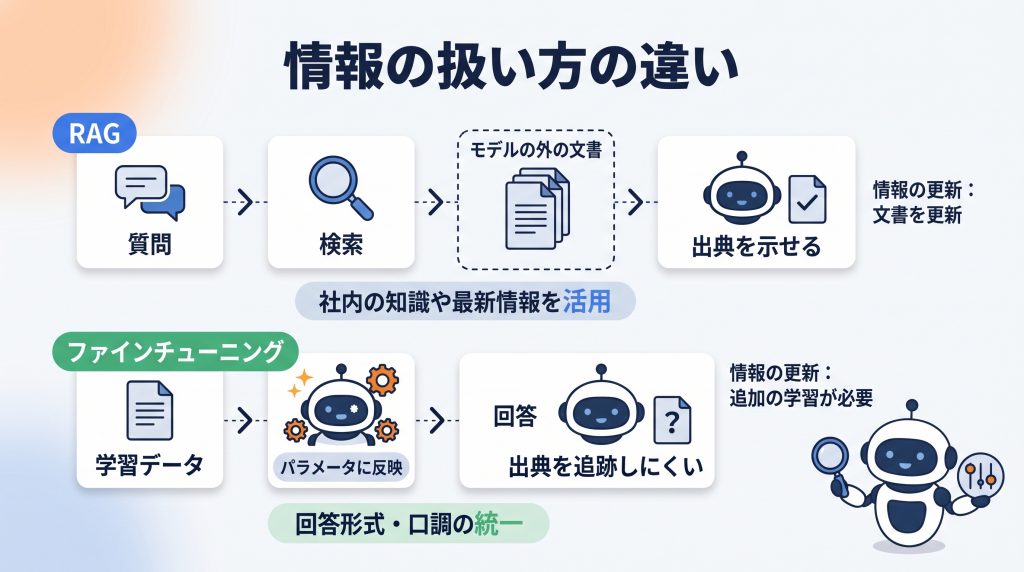
RAGは必要な情報を検索して回答に活用する仕組み、ファインチューニングは追加学習によってモデルの回答の傾向を調整する手法です。
社内の知識を参照させたいのか、回答の仕方を揃えたいのかによって、適した手法が変わります。
両者の主な違いは、次のとおりです。
| 比較項目 | RAG | ファインチューニング |
|---|---|---|
| 主な目的 | 社内の知識や最新情報を回答に活用する | 回答形式・口調の統一やタスクの精度向上を図る |
| 情報の扱い | モデルの外にある文書を検索して参照する | 学習データの傾向をモデルのパラメータに反映する |
| 情報の更新 | 参照文書や検索用データを更新する | 学習内容を更新するには追加の学習が必要 |
| 根拠の提示 | 参照した文書や該当箇所を示せる | 学習だけでは回答の出典を追跡しにくい |
| 主な準備 | 文書の整備と検索精度の調整 | 目的に合った高品質な学習データの作成 |
| 権限の制御 | 検索時に利用者の閲覧権限を反映できる | 学習した情報を利用者ごとに出し分けるのは難しい |
例えば、人事情報のように閲覧者を限定する必要がある情報は、ファインチューニングの扱いに注意が必要です。
モデルに学習させた情報は、利用者の権限に応じて回答への反映を制御しにくくなります。
一方、RAGでは、検索時に権限を確認する設計により、その利用者が閲覧できる文書だけを参照させることが可能です。
知識を参照させる用途では、RAGの優位性を示す研究もある
知識に基づく質問への回答では、RAGがファインチューニングを上回った研究結果もあります。
EMNLP 2024で発表された論文では、複数の知識集約型タスクでRAGと教師なしファインチューニングを比較しました。
その実験では、モデルが事前学習で触れた知識と新しい知識のどちらについても、RAGが一貫して高い性能を示しています。
また、教師なしのファインチューニングで新しい事実を学習させる難しさも指摘されています。
ただし、この結果は特定の実験条件に基づくもので、すべてのファインチューニング方式に当てはまるわけではありません。
実務では、社内文書や最新情報の参照にはRAG、回答形式や口調などの調整にはファインチューニングを検討すると、目的を整理しやすくなります。
両方が必要な場合は、組み合わせて活用することも可能です。
関連記事:RAGとは?生成AIでの社内データ活用による作り方と事例をわかりやすく解説
RAGとファインチューニングのどちらが自社に合うか迷った場合は、以下3つの判断軸を確認してみてください。
| 判断軸 | RAGが向いているケース | ファインチューニングが向いているケース |
|---|---|---|
| 改善したい内容 | 回答に必要な情報が不足している | 情報は足りているが、回答の仕方やタスクの精度に課題がある |
| 扱う情報の更新頻度 | 規程や製品情報などが頻繁に変わる | 比較的変わりにくい回答ルールや分類基準を学習させたい |
| 用意できるデータ | 回答の根拠となる文書が揃っている | 入力と理想の回答など、高品質な学習例が揃っている |
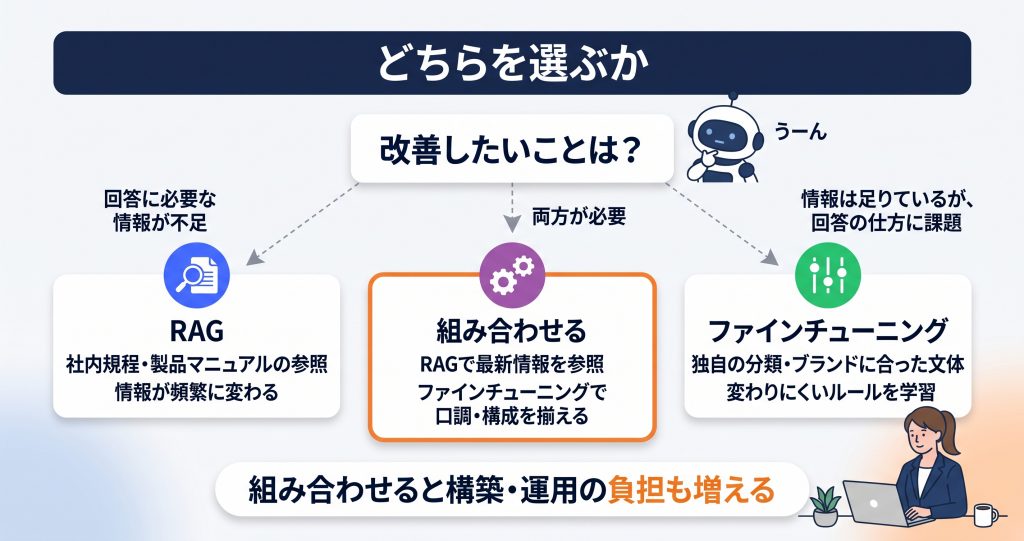
例えば、社内規程への問い合わせや、製品マニュアルを参照する顧客対応にはRAGが適しています。
一方、社内独自のカテゴリへの分類や、ブランドに合った文体の再現には、ファインチューニングを検討できます。
両方の要件がある場合は、組み合わせる方法もあります。
サポート窓口で最新の製品情報をRAGで参照し、回答の口調や構成をファインチューニングで揃える、といった使い方です。
ただし、組み合わせると構築・運用の負担も増えます。
必要な情報を参照できていないのか、回答の仕方に問題があるのかを切り分け、各手法で解決する課題を明確にすることが大切です。
PoC(実証実験)から要件定義・開発まで一貫して支援します。
2026年には、ファインチューニングを検討するうえで見逃せない変化がありました。
本章では、以下の2点を解説します。
- OpenAIの変更内容:新規利用者への提供を停止し、既存利用者も段階的に終了
- 今後の選択肢:他のクラウドやオープンモデル、ベンダーに依存しない設計
OpenAIは新規利用者への提供を2026年5月に停止
OpenAIは、2026年5月8日付の公式ブログの更新で、新規利用者はファインチューニング基盤を利用できなくなったと案内しています。
OpenAIの公式廃止スケジュールでは、過去にファインチューニングを実行していない組織は、2026年5月7日から新たな学習を利用できません。
さらに、2026年7月2日からは、過去60日間にファインチューニング済みモデルで推論を実行していない組織も、学習ジョブを作成できなくなりました。
継続利用中の既存顧客も、2027年1月6日以降は新たな学習ジョブを作成できなくなります。
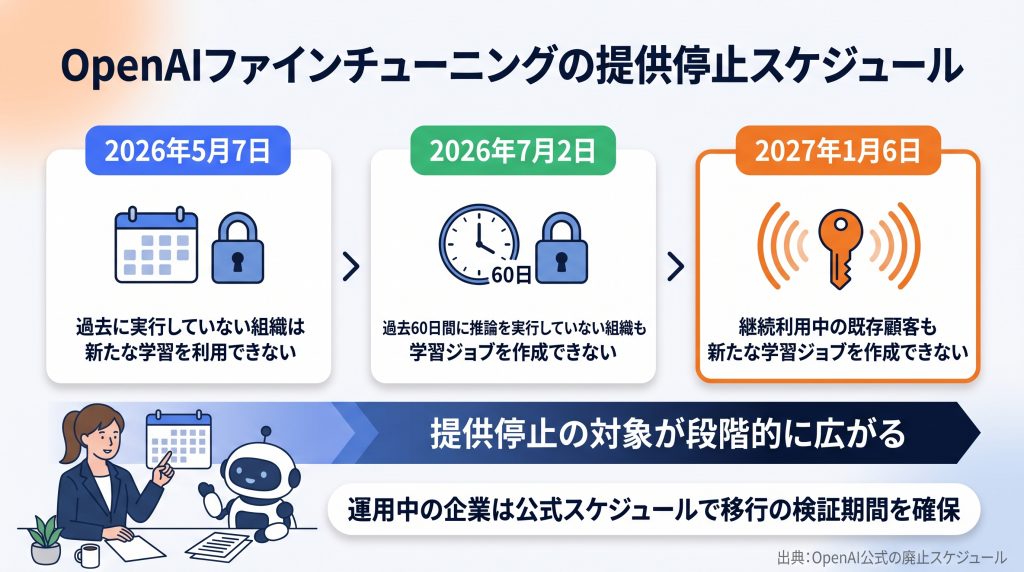
運用中の企業は、公式の廃止スケジュールを確認し、移行に必要な検証や開発の期間を確保しておきましょう。
今後の選択肢と、移行を見据えた設計
ファインチューニングを行う方法は、OpenAI以外にもあります。
Google Cloudでは、Gemini 2.5 Pro/Flash/Flash-Liteなどの教師ありファインチューニングが提供されています。
AI開発プラットフォームの選び方と代表的なサービスについて詳しく知りたい方は、以下の記事をご覧ください。
関連記事:AI開発プラットフォームの選び方と代表的サービスを解説
また、重みが公開されたモデルを、利用条件の範囲内でLoRAなどにより調整する方法もあります。
こうした提供状況の変化に対応するには、モデルを変更しても学習・評価の資産を活用できる設計が大切です。当社では、次の2点を重視しています。
- 学習データと評価データをモデルと分けて管理する:別のモデルでも再利用できるよう、元データや評価基準を残す
- 同じ評価基準で移行先を比較する:回答品質だけでなく、費用や応答速度、運用条件も確認する
特定のサービスの継続提供を前提にせず、移行先でも必要な品質を満たせるか検証できる状態を整えておきましょう。
ファインチューニングでは、学習前に評価基準を決め、学習後に改善効果を確認することが大切です。データを追加学習させるだけでは、業務に必要な精度を満たせるとは限りません。
ここでは、導入の流れと、効果を得るために避けたい失敗を解説します。
ファインチューニングの進め方4ステップ
ファインチューニングを導入する際は、まず「何を改善したいか」「どの水準なら業務で使えるか」を明確にし、次の順序で進めます。
| ステップ | 実施する内容 |
|---|---|
| 1. 評価基準を決める | 実際の業務を想定したテストと、正誤・形式・口調などの採点基準を用意する |
| 2. 現状の性能を測る | 追加学習前のモデルをテストし、改善が必要な点を把握する |
| 3. 学習データを整える | 改善したい点に対応する学習例を作成し、誤りや判断基準のばらつきを確認する |
| 4. 学習・比較・運用する | 学習に使っていない評価データで効果を比較し、導入後も回答品質を確認する |
当社では、追加学習の効果を客観的に判断できるよう、評価の仕組みを整えてから学習に進むことを基本方針としています。
学習前後を同じ条件で比較することで、改善した点と残る課題を把握できます。
費用を見積もる際は、学習そのものの料金に加え、データの作成・確認にかかる人件費も考慮しましょう。
運用開始後の評価や、業務ルールの変更に伴うデータ修正・再学習にも費用がかかります。
AI機能を搭載したシステム開発の費用と抑え方について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:AIを活用したアプリ開発に必要なコストは?コストを抑える考え方も解説!
ファインチューニングでよくある3つの失敗
ファインチューニングでよくある失敗は、目的に合わない使い方、学習データの品質不足、効果検証の不足です。
| 失敗パターン | 起きる問題 | 対策 |
|---|---|---|
| 頻繁に変わる情報を学習させる | 更新のたびに再学習が必要になり、古い情報に基づいて回答するおそれがある | 更新される情報はRAGで参照させる |
| データの量を質より優先する | 誤った回答や、一貫しない判断・表現まで学習してしまう | 正確さと基準の統一を確認してから学習に使う |
| 評価せずに本番へ導入する | 改善効果や、業務で使える水準に達したかを判断できない | 学習前後を同じ評価データで比較する |
特に、学習に使った例だけで評価すると、未知の入力にも対応できるかを見誤るおそれがあります。
実際の業務で想定される入力を別途用意し、対応が難しいケースも含めて確認しましょう。
当社では、お客様の課題に応じたAIシステムの開発に加え、自社でも生成AIを業務に活用しています。
ここでは、2つの開発事例と、日々の実践から得た手法選びの判断基準をご紹介します。
文書検索と入稿チェックにAIを活用した開発事例
A社様向けには、Excel・Word・PDFなどの文書を参照して回答するRAGシステムを開発しました。
文書を意味のまとまりで分割する「セマンティックチャンク技術」を採用し、回答精度の向上とトークン使用量の削減を図っています。
文書の更新にも、モデルの再学習をせずに対応できる構成です。
また、株式会社ヤマハミュージックジャパン様向けには、AI入稿管理システムを開発しました。
入稿データの表記・文法や日付の整合性をチェックし、改善案を提案するシステムです。
チェック項目ごとに機能を分け、要件定義から検証まで約1.5か月で開発しました。
このように、必要な情報を参照する仕組みや、確認する項目を明確にした設計によって、業務上の課題に対応しています。
自社での生成AI活用から得た、手法選びの判断基準
当社では、「自分たちが使えないものは、お客様に提案しない」という方針のもと、生成AIの業務活用を進めています。
日々の活用で実感しているのは、モデルの進化によって、同じ業務でも適した手法が変わることです。
以前は追加学習が必要と考えていた課題が、モデルやプロンプトの見直しで解決できる場合もあります。
AI開発におけるモデル選定の基準と実装時の注意点について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:AI開発で失敗しないモデル選定とは?実装・運用・ハルシネーション対策まで解説
そのため、当社では次の点を重視しています。
- 同じ評価データで比較する:モデルや手法の変更によって、どの程度改善したかを確認する
- 課題の原因を切り分ける:参照情報の不足なのか、回答形式や判断のばらつきなのかを見極める
- 必要な改善に合う手法を選ぶ:RAGやプロンプト設計で残る課題を確認し、追加学習の効果が見込める場合にファインチューニングを検討する
特定の手法を前提にせず、実際の業務で求められる品質を満たせるかを確かめることが、当社のAI開発の基本です。
最後に、ファインチューニングとRAGに関するよくある質問を紹介します。
ファインチューニングとRAGは、どちらが安いですか?
データは何件くらい必要ですか?
ChatGPTをファインチューニングできますか?
ハルシネーションはなくなりますか?
本記事では、ファインチューニングとは何か、RAGとの使い分けや導入のポイントを解説しました。
社内文書や最新情報を参照して回答させたい場合はRAG、回答形式や口調、分類の精度を調整したい場合はファインチューニングが選択肢になります。
まずは自社の課題を整理し、何を改善するために導入するのかを明確にしましょう。
また、導入前に評価基準を決め、実際の業務で求める品質を満たせるか検証することも大切です。
手法の導入そのものを目的にせず、改善効果と開発・運用コストを比較して判断しましょう。
なお、OpenAIの提供方針の変更に見られるように、利用できるサービスやモデルは変わります。
学習データと評価データを再利用できる形で管理し、将来の移行にも備えることが、継続的なAI活用につながります。
ファインチューニングやRAGの導入をご検討の方は、お気軽にご相談ください。