LLM(大規模言語モデル)とは?仕組み・生成AIとの違い・開発方法をわかりやすく解説
「LLMという言葉をよく聞くが、生成AIやChatGPTとの違いが分からない」
「自社でも活用したいが、何から始めればよいか分からない」
こうした声は、情報システム部門やDX推進部門のご担当者から多く寄せられます。
LLM(大規模言語モデル)は、大量のテキストデータを学習し、文章の生成や要約、質問への回答などを行うAIモデルです。
ChatGPTのような生成AIサービスを支える技術であり、社内の問い合わせ対応や資料作成などにも活用できます。
ただし、業務で成果を出すには、LLMの得意・不得意を理解し、自社の課題に合った使い方を選ぶことが大切です。
本記事では、全社で生成AIの業務活用に取り組むCLINKSが、LLMの基本的な仕組みや生成AIとの違い、企業での活用例、開発の進め方を解説します。
自社での導入を検討する際に、何から始めるべきかを整理できます。
また、社内で安全に活用するための選択肢として、法人向け生成AIプラットフォーム「ナレフルチャット」もご紹介します。
目次
LLM(Large Language Model:大規模言語モデル)とは、大量のテキストデータを学習し、文章の生成や要約、翻訳などを行うAIモデルです。
文章に含まれる言葉の関係やパターンを学習することで、質問や指示に応じた自然な文章を生成します。
代表的な生成型LLMは、文脈に続く文字や単語の断片(トークン)を予測し、その処理を繰り返して回答を作ります。
ここでは、LLMでできることと、注目されるようになった背景を解説します。
LLMでできること
LLMの特徴は、文章による指示に応じて、さまざまな作業を一つのモデルで行えることです。
業務では、次のような用途に活用できます。
| できること | 業務での活用例 |
|---|---|
| 文章生成 | メール文案や提案書の下書き |
| 要約 | 議事録の要約や報告書のポイント抽出 |
| 翻訳 | 海外取引先へのメール作成や英語資料の和訳 |
| 質問応答 | 社内規程やマニュアルに関する問い合わせ対応 |
| コード生成 | プログラムの作成や修正の補助 |
たとえば、会議の記録を渡して「決定事項と担当者を整理して」と指示すれば、指定した形式で要約できます。
文章の用途や読み手を伝え、表現を調整することも可能です。
ただし、社内規程などの独自情報について回答させるには、参照する資料を与える仕組みが必要です。
また、誤った内容を生成する場合もあるため、業務で使う際は出力内容を確認しましょう。
LLMが注目されるようになった背景
LLMが注目される背景には、言語処理技術の進歩と、対話形式で使えるサービスの普及があります。
技術面で大きな転機となったのが、2017年の論文「Attention Is All You Need」で提案された「Transformer」です。
文章中の単語どうしの関係を捉える仕組みを採用し、学習処理を並列化しやすくしました。
この技術を土台に、学習データやモデルの規模が拡大し、幅広い文章処理に対応できるLLMが登場しました。
さらに、ChatGPTなどの対話型サービスによって、専門的なプログラミング知識がなくてもLLMを利用しやすくなりました。
文章で依頼するだけで作業を進められる手軽さから、企業でも資料作成や問い合わせ対応などへの活用が広がっています。
AIは技術の総称、生成AIはコンテンツを作るAI、LLMは言語を扱うモデル、ChatGPTはそのモデルを利用したサービスです。
それぞれが指す範囲を分けると、関係を理解しやすくなります。
| 用語 | 意味 |
|---|---|
| AI | 言語処理や画像認識、予測など、人間の知的な作業をコンピューターで行う技術の総称 |
| 生成AI | 文章・画像・音声などのコンテンツを生成するAI |
| LLM | 大量のテキストデータを学習し、文章の生成や要約などを行うモデル |
| ChatGPT | LLMなどのAIモデルを、対話形式で利用できるサービス |
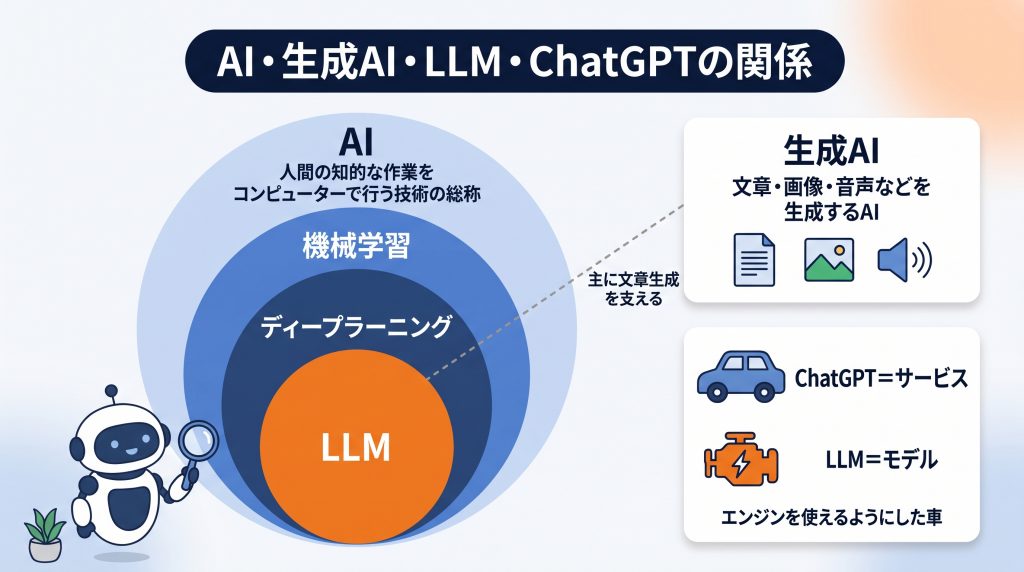
以下では、LLMと各用語の違いを詳しく解説します。
AIとLLMの違い
LLMは、AIに含まれるモデルの一種です。
AIには、文章を扱うものだけでなく、画像から物体を認識するものや、過去のデータから需要を予測するものもあります。
LLMは、データからパターンを学ぶ「機械学習」のうち、多層のニューラルネットワークを使う「ディープラーニング」に基づいています。
大量の文章を学習し、言語に関する幅広い作業に対応する点が特徴です。
つまり、AIとLLMは別々の技術を指す言葉ではなく、AIという広い枠組みの中にLLMが位置づけられます。
生成AIとLLMの違い
生成AIはコンテンツを生成するAIの総称で、LLMは主に文章生成を支えるモデルです。
生成AIには、文章を作るAIのほか、画像や音声、動画を生成するAIも含まれます。
一方、LLMは言語を中心に扱い、文章の作成や要約、翻訳、コード生成などに利用されます。
また、近年は文章に加えて画像や音声も扱う「マルチモーダルモデル」が登場しています。
そのため、LLMを使ったサービスでも、画像の内容を読み取ったり、音声で対話したりできる場合があります。
ChatGPTとLLMの違い
LLMは回答を生成するモデルで、ChatGPTはそのモデルを使えるようにしたサービスです。
利用者がChatGPTの画面に質問を入力すると、背後にあるAIモデルが入力内容を処理し、回答を生成します。
サービスには、モデルに加えて、会話の履歴を管理したり、ファイルを受け取ったりする機能も組み込まれています。
企業で導入する際は、モデルの性能だけでなく、操作性や管理機能、入力データの扱いも確認することが大切です。
当社が開発した法人向け生成AIプラットフォーム「ナレフルチャット」は、複数のLLMを一つの画面で切り替えて使える法人向けサービスです。
業務の目的に応じてモデルを選び、社内で活用できます。
LLMは、入力された文章を数値として処理し、文脈に続く「トークン」を予測することで回答を生成します。
トークンとは、文字や単語の断片など、文章を処理するための小さな単位です。
回答を生成する流れは、大きく次の5つのステップに分けられます。
| ステップ | 処理内容 |
|---|---|
| ①トークン化 | 入力された文章をトークンに分ける |
| ②ベクトル化 | 各トークンを、モデルが計算できる数値の列に変換する |
| ③文脈の処理 | トークン同士の関係を計算し、文脈を反映した情報に変換する |
| ④次のトークンの予測 | 続きに来るトークンの確率を計算し、一つを選ぶ |
| ⑤文章の生成 | 選んだトークンを追加して予測を繰り返し、回答を作る |
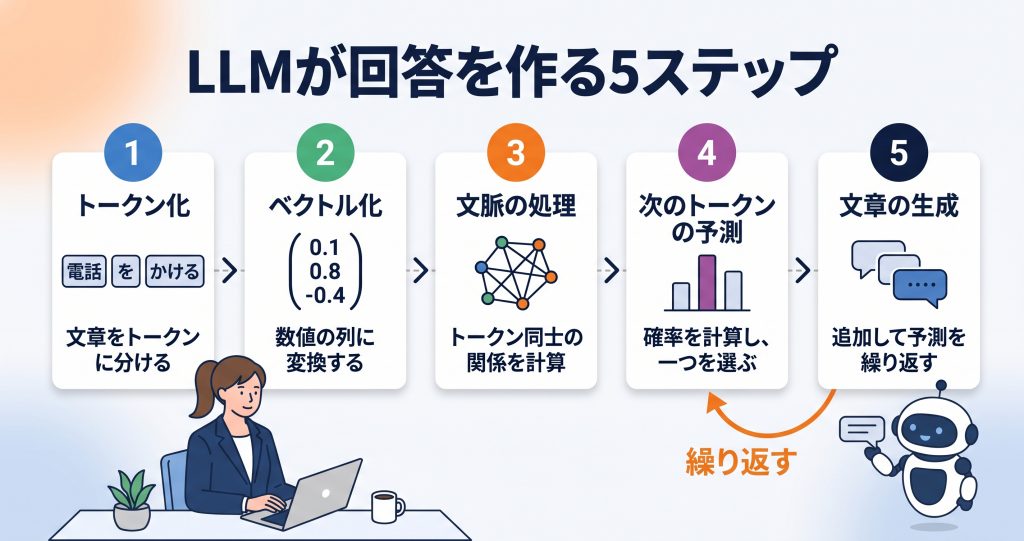
ここでは、文脈を処理する仕組みと、LLMが誤った回答を生成する理由を解説します。
言葉同士の関係を計算し、次のトークンを予測する
LLMは、入力された言葉同士の関係を計算し、その文脈に合う続きを予測します。
この処理を支えるのが、Transformerの「自己注意(Self-Attention)」という仕組みです。
たとえば、「電話をかける」と「眼鏡をかける」では、同じ「かける」でも意味が異なります。
自己注意は、このように周囲の言葉との関係を計算し、文脈に応じた処理を行うための仕組みです。
その結果をもとに、次に続くトークンの候補と確率を計算します。選んだトークンを末尾に加え、さらに次を予測する処理を繰り返すことで、回答ができあがります。
こうした処理の土台は、大量の文章を使った「事前学習」で作られます。
対話向けのモデルでは、さらに指示に沿って回答するための追加学習や調整が行われます。
誤った内容をもっともらしく生成することがある
LLMは、自然な文章を生成できても、内容の正しさを保証できるわけではありません。
事実と異なる内容や、根拠のない情報をもっともらしく生成する現象を「ハルシネーション」と呼びます。
LLM単体の生成処理は、文脈に続くトークンを予測する仕組みです。
そのため、学習していない情報や曖昧な質問に対しても、実在しない制度や資料名などを回答する場合があります。
検索や社内資料の参照を組み合わせれば、回答の根拠を補えます。
ただし、それでも誤りを完全になくせるわけではありません。
業務で利用する際は、自然な文章であることと、正確な情報であることを分けて判断する必要があります。
特に数値や固有名詞、重要な判断に関わる内容は、出典や原資料で確認しましょう。
生成AIのハルシネーションが起きる仕組みと業務での対策について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:生成AIのハルシネーション対策と業務リスク統制の実践ガイド
LLMを業務に定着させるには、安全に使える環境、社内情報を参照する仕組み、社員への活用支援を整えることが大切です。
ツールを導入するだけでは、現場の不安や使いづらさが残り、十分に活用されない場合があります。
ここでは、企業での活用を進める際に直面しやすい課題と対策を、3つに分けて解説します。
| 課題 | 対策 |
|---|---|
| 情報漏洩への不安がある | 入力ルールを定め、データの扱いやアクセス権限を確認する |
| 社内の情報に回答できない | RAGで社内文書を検索・参照させる |
| 一部の社員しか使わない | スキルに応じた研修と、業務に役立つ活用事例の共有を行う |
情報漏洩への不安|入力ルールと利用環境を整える
情報漏洩のリスクを抑えるには、社員が守るルールと、利用するサービスの両方を整える必要があります。
まずは、個人情報や顧客情報、未公開の事業情報などについて、入力できる範囲を社内ガイドラインで定めましょう。
利用を認めるツールや、判断に迷ったときの相談先も明確にすると、現場で運用しやすくなります。
あわせて、サービスの入力データが学習に使われるか、どのように保存されるかを確認します。
法人向けサービスでも、契約条件や設定によってデータの扱いは異なります。
アクセス権限や利用履歴の管理機能も含め、自社の要件に合う環境を選ぶことが大切です。
生成AIの情報漏洩が起きる仕組みと防止策について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:生成AIの情報漏洩が起きる仕組みと事例|業務で安全に運用するための防止策
社内の情報に回答できない|RAGで社内文書を参照させる
就業規則や製品マニュアルなど、自社固有の情報に回答させたい場合は、RAGの活用が有効です。
一般的なLLMは、非公開の社内文書をあらかじめ学習しているわけではありません。
RAG(検索拡張生成)は、質問に関連する文書を検索し、その内容をLLMに渡して回答を生成する仕組みです。
LLM自体を追加学習させずに、社内情報を回答に反映できます。
ただし、正確に回答させるには、参照する文書の整理や更新が欠かせません。
また、社員ごとに閲覧できる文書が異なる場合は、その権限を検索や回答にも反映する必要があります。
関連記事:RAGとは?生成AIでの社内データ活用による作り方と事例をわかりやすく解説
一部の社員しか使わない|スキルに応じた育成と事例共有を進める
全社で活用を広げるには、社員の習熟度に合わせた支援が必要です。
操作方法を一度説明するだけでは、自分の業務でどう使えばよいか分からず、利用が止まってしまう場合があります。
初心者にはメール作成や要約など、日常業務で試しやすい使い方を紹介しましょう。
活用が進んだ社員には、指示の工夫や業務プロセスへの組み込み方を学ぶ機会を設けます。
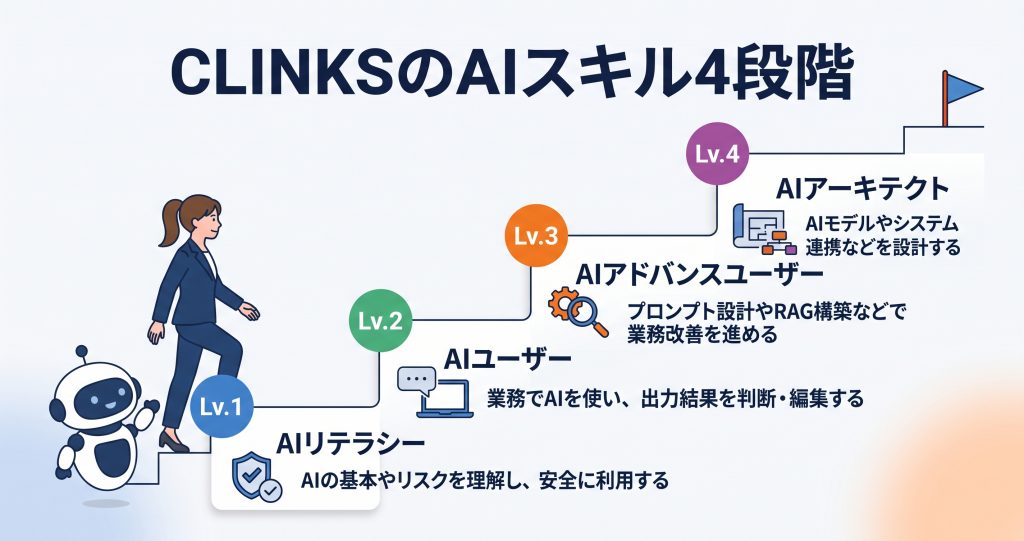
当社では、AIスキルを次の4段階で定義し、社員が現在の習熟度と次の目標を把握できるようにしています。
| レベル | 名称 | 目指すスキル |
|---|---|---|
| Lv.1 | AIリテラシー | AIの基本やリスクを理解し、安全に利用する |
| Lv.2 | AIユーザー | 業務でAIを使い、出力結果を判断・編集する |
| Lv.3 | AIアドバンスユーザー | プロンプト設計やRAG構築などで業務改善を進める |
| Lv.4 | AIアーキテクト | AIモデルやシステム連携などを設計する |
さらに、社内の活用事例を共有し、他の社員が自分の業務にも取り入れられるようにしています。
研修と事例共有を組み合わせることが、継続的な活用につながります。
取り組みの全体像は「「導入して終わり」にしない!CLINKSが実践する生成AI活用とAI人材育成の全戦略」で紹介していますので、あわせて参考にしてください。
企業がLLMを活用する際は、モデルをゼロから作るよりも、既存のLLMを業務に組み込む方法が現実的です。
「LLM開発」には、モデルそのものを開発する場合と、既存のモデルを使ったシステムを開発する場合があります。
社内の問い合わせ対応や資料作成を効率化したいのであれば、まずは既存のLLMで実現できる範囲を確かめましょう。
AIを自社で作る場合と外部に任せる場合の判断基準について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:AIの作り方|自社で作る場合と外部に任せる場合の判断基準
ここでは、LLMを活用する主な手法と、当社の開発事例・業務での活用実績を紹介します。
LLMを活用する4つの手法
LLMの開発手法は、解決したい課題と、既存のLLMだけでは対応できない部分に合わせて選びます。
主な選択肢は次の4つです。
| 手法 | 内容 | 費用・開発負担の目安 | 向いているケース |
|---|---|---|---|
| プロンプト設計 | 指示や回答例を工夫し、既存のLLMから求める出力を引き出す | 比較的小さい | 文章作成や要約などの効果を試したい |
| RAG | 関連する社内文書を検索し、LLMに参照させる | 文書量や権限設計によって変わる | 社内規程や製品情報に基づいて回答させたい |
| ファインチューニング | 学習用データで既存のモデルを追加学習させる | データ整備や学習・評価の負担がかかる | 回答形式や文体、特定の作業への対応を安定させたい |
| 独自LLM開発 | 大量のデータと計算資源を使い、モデルをゼロから学習させる | 非常に大きい | モデル自体の開発・提供を事業にしたい |
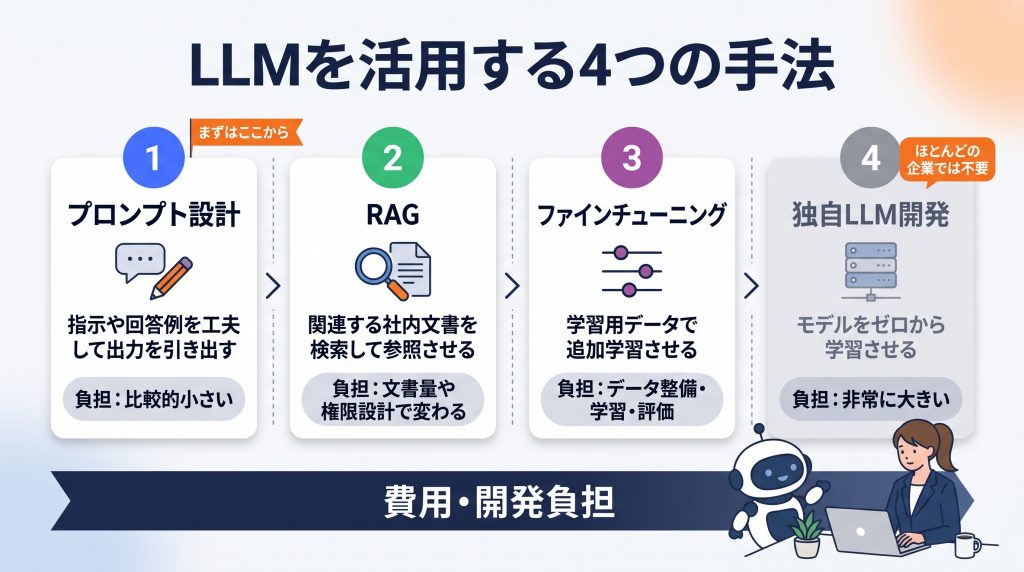
当社では、まずプロンプト設計で効果を確かめ、社内情報の参照が必要であればRAGを検討する進め方をおすすめしています。
それでも回答の形式や振る舞いが安定しない場合に、ファインチューニングの必要性を判断します。
最初から大規模な開発を進めるのではなく、対象業務を絞って試し、回答の品質や作業時間を評価しながら広げることが大切です。
関連記事:AI開発ロードマップとは?企画・PoC・運用までの実装に向けた進め方
CLINKSの開発事例と自社での活用実績
当社では、お客様のシステム開発に加え、自社業務でもLLMを活用し、効果や課題を検証しています。
開発事例の一つが、ヤマハミュージックジャパン様の「AI入稿管理システム」です。
OpenAI Agents SDK・Next.js・AWSを用い、要件定義から検証まで約1.5か月で構築しました。
AIエージェントの仕組みと業務での使い方について詳しく知りたい方は、以下の記事をご覧ください。
関連記事:AIエージェントとは?仕組み・種類・業務での使い方を実例でわかりやすく解説
また、「自分たちが使えないものは、お客様に提案しない」という方針のもと、報告書の作成やナレッジの整理などにも活用しています。
自社での活用による成果は、以下のとおりです(当社実績、2026年7月時点)。
| 対象業務 | 活用による変化 |
|---|---|
| インシデント報告の作成 | 1件あたりの作成時間が60分から10分に短縮 |
| 資材作成 | 作業時間が3時間から1時間に短縮 |
| ナレッジ記事へのキーワード付与 | 約71時間かかっていた作業の時間を99%以上削減 |
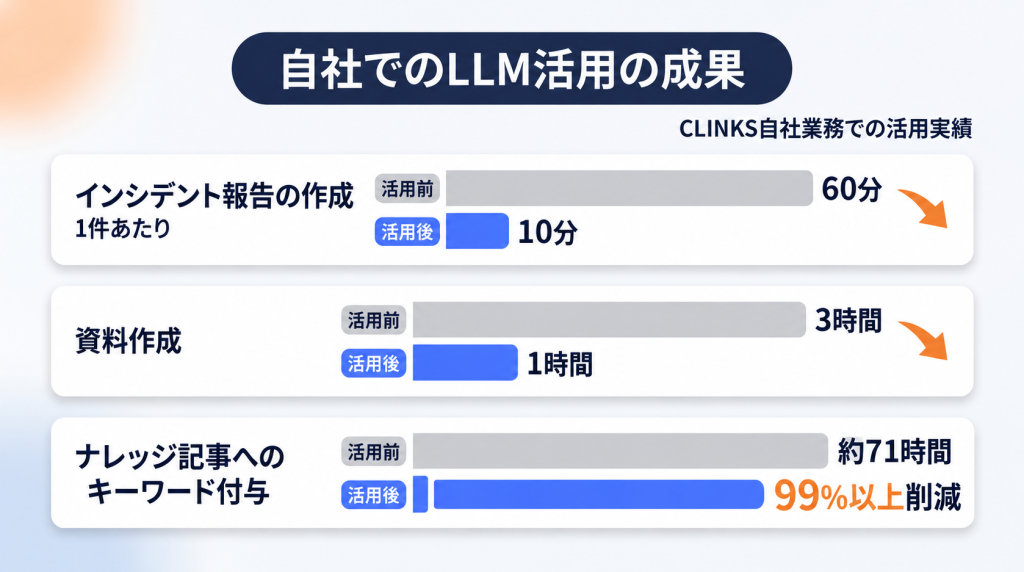
当社では、自社での実践を通じて、LLMに任せやすい作業や、人による確認が必要な場面を整理しています。
その知見をもとに、お客様の業務に合った開発手法や運用方法をご提案します。
最後に、LLMに関するよくある質問を紹介します。
LLMとChatGPTの違いは何ですか?
LLMに社内の情報を入力しても大丈夫ですか?
自社専用のLLMを作る必要はありますか?
LLMは、大量のテキストデータを学習し、文章の生成や要約、翻訳などを行うAIモデルです。
ChatGPTなどのサービスを支える技術であり、企業でも資料作成や社内の問い合わせ対応に活用できます。
ただし、自然な文章を生成できても、内容が正しいとは限りません。
業務で成果を出すには、出力内容の確認に加え、入力ルールの整備や社員への活用支援が必要です。
導入を進める際は、既存のLLMを使い、身近な業務で効果を確かめることから始めましょう。
社内情報の参照が必要ならRAGを検討するなど、課題に応じて仕組みを整えることが大切です。
CLINKSでは、自社での実践と開発経験をもとに、業務の選定からシステム開発、社内への定着まで支援しています。
「自社で何に使えるか知りたい」という段階でも、お気軽にご相談ください。